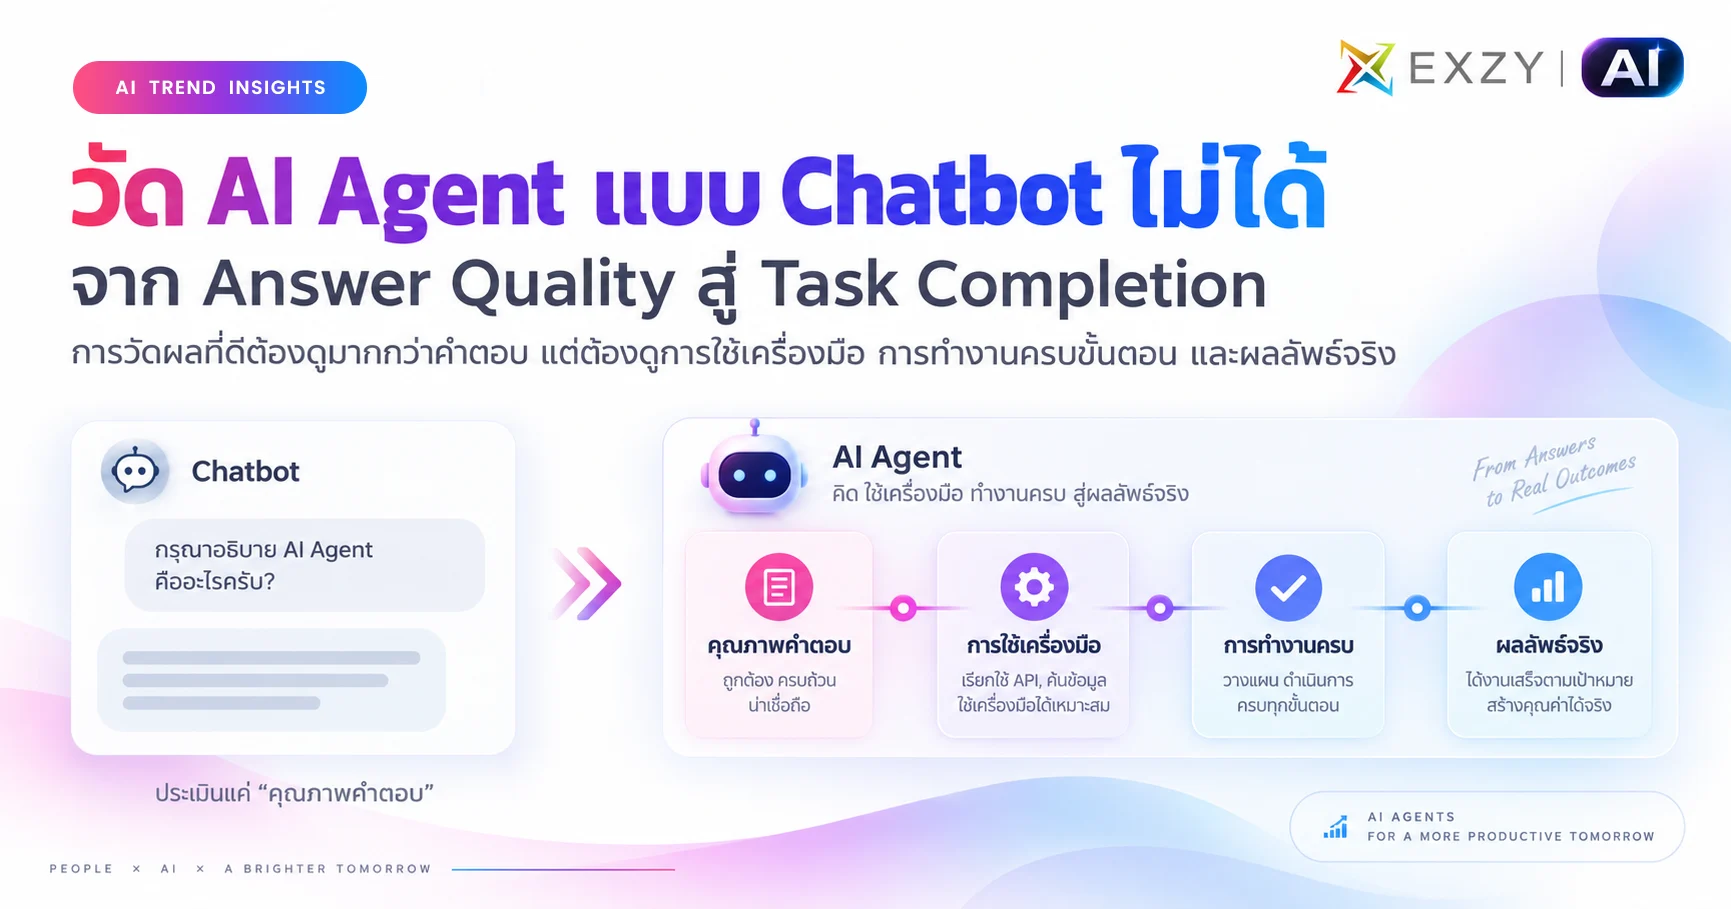
AI Agent อาจตอบได้อย่างมั่นใจว่า “ดำเนินการเรียบร้อยแล้ว” แต่ในระบบจริง งานนั้นอาจยังไม่สำเร็จ อัปเดตข้อมูลผิด หรือทำ Action ไม่ครบตามขั้นตอน นี่คือเหตุผลที่การวัด AI Agent ด้วยมาตรฐานเดียวกับ Chatbot เช่น ความถูกต้องของคำตอบหรือความลื่นไหลของภาษา เริ่มไม่เพียงพอ เพราะสิ่งที่สำคัญกว่า คือหลังจาก Agent ทำงานเสร็จแล้ว Task สำเร็จจริงหรือไม่ ระบบอยู่ใน State ที่ถูกต้องหรือไม่ และต้องให้คนเข้ามาแก้ไขมากแค่ไหน
วันนี้ Exzy AI อยากชวนคุณมาทำความเข้าใจว่า AI Agent Evaluation ควรวัดอะไรบ้าง ตั้งแต่ Task Completion, Tool Reliability และ Human Correction ไปจนถึง Cost, Latency และความเสี่ยงจาก Action ที่ผิดพลาด เพื่อให้องค์กรสามารถประเมินได้ว่า Agent ที่ดูเหมือน “ทำงานได้” นั้น พร้อมสร้างผลลัพธ์ให้กับธุรกิจจริงแล้วหรือยัง
Table of Contents
Toggleทำไมคะแนนคำตอบดี ยังไม่แปลว่า Agent ทำงานสำเร็จ ?
Chatbot แบบเดิมมักถูกประเมินจากคำตอบ: ถูกไหม ตรงคำถามไหม อ่านรู้เรื่องไหม แต่ AI Agent ทำมากกว่านั้น มันอาจเรียก Tool หลายครั้ง อ่านข้อมูลหลายระบบ แก้ State และตัดสินใจหลายขั้นก่อน Task จะจบ
Anthropic ชี้ว่าความสามารถที่ทำให้ Agent มีประโยชน์ – การทำงานหลาย Turn, ใช้ Tool และเปลี่ยน State ของ Environment – คือสิ่งเดียวกันที่ทำให้การ Eval ซับซ้อนขึ้น เพราะความผิดพลาดหนึ่งจุดสามารถส่งผลต่อขั้นตอนถัดไปได้
ดังนั้นคำถามหลักไม่ควรเป็นแค่ “Agent ตอบดีหรือไม่?” แต่คือ “หลัง Agent ทำงานเสร็จ โลกหรือระบบอยู่ใน State ที่ถูกต้องหรือไม่?”
Outcome สำคัญกว่า Transcript
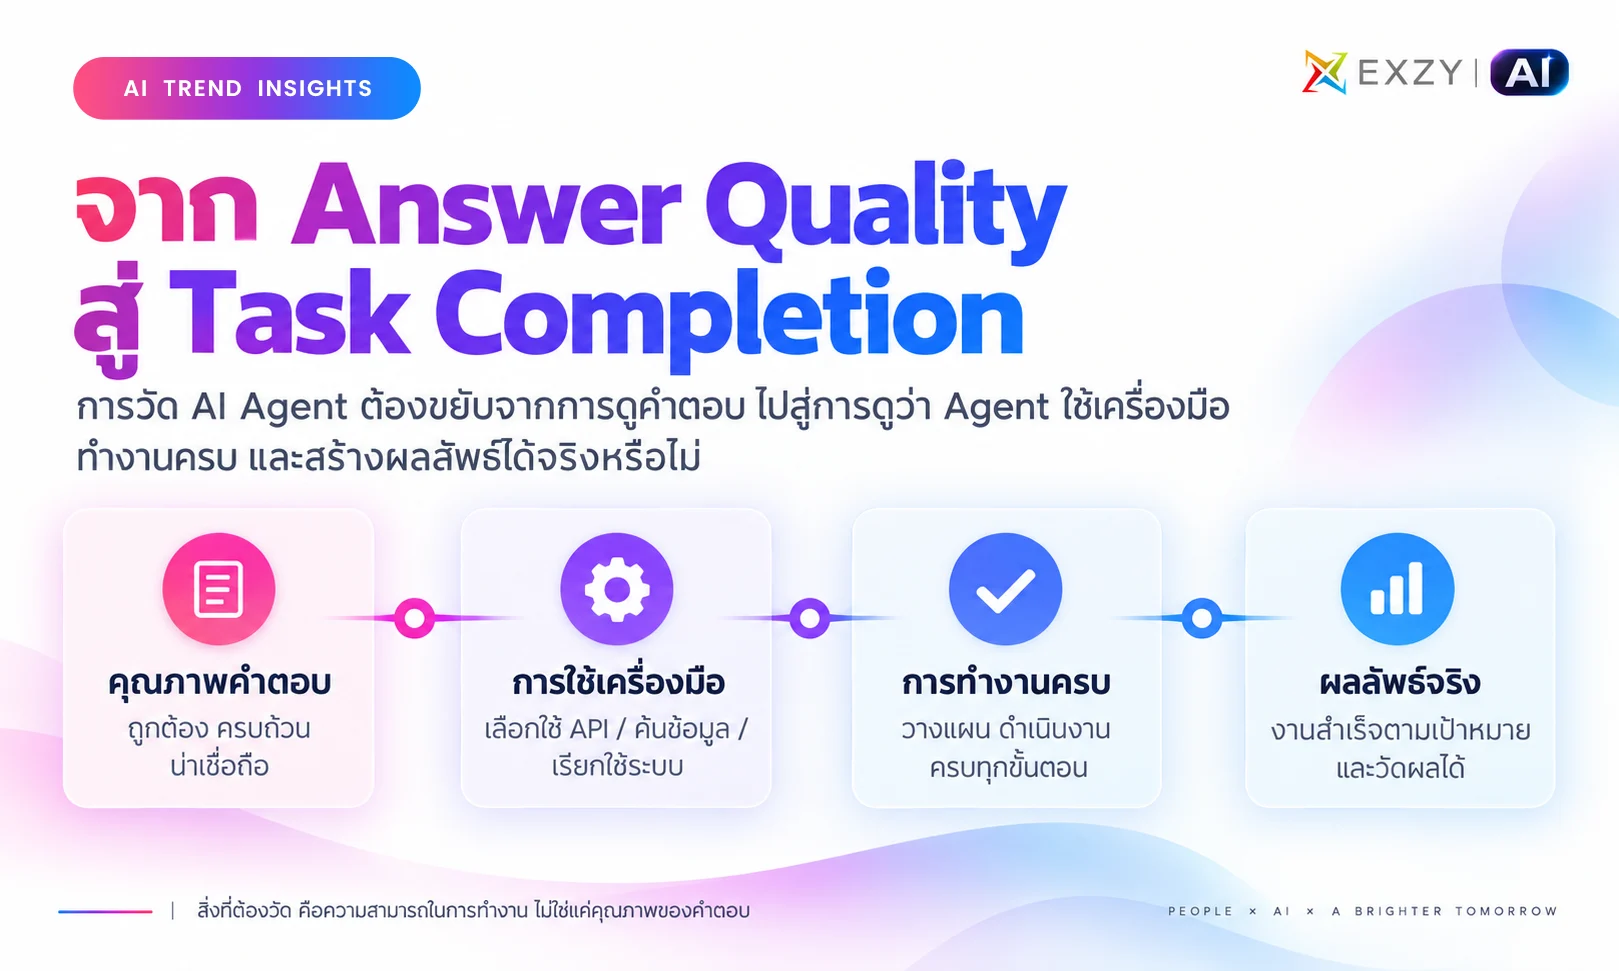
Agent อาจพูดว่า “จองเที่ยวบินเรียบร้อยแล้ว” แต่สิ่งที่ต้องตรวจจริงคือ Reservation ถูกสร้างในระบบหรือไม่ นี่คือความต่างระหว่างการดู Transcript กับการดู Outcome
ในงานองค์กรหลักเดียวกันใช้ได้กับหลาย Use Case เช่น
- Customer Support – ไม่ใช่แค่ตอบ Refund Policy ถูก แต่ Refund ถูกสร้างด้วยจำนวนและ Account ที่ถูกหรือไม่
- Sales Ops – ไม่ใช่แค่สรุป Lead ดี แต่ CRM ถูกอัปเดต Field ที่ถูกต้องหรือไม่
- IT Operations – ไม่ใช่แค่เสนอวิธีแก้ แต่ Ticket, Permission หรือ Configuration ถูกเปลี่ยนตาม Policy หรือไม่
- Finance Workflow – ไม่ใช่แค่คำนวณถูก แต่ Approval และ Transaction State ถูกต้องหรือไม่
นี่ทำให้ Task Completion ต้องเป็นแกนของ Agent Eval
Agent Evaluation ควรวัดอะไรบ้าง
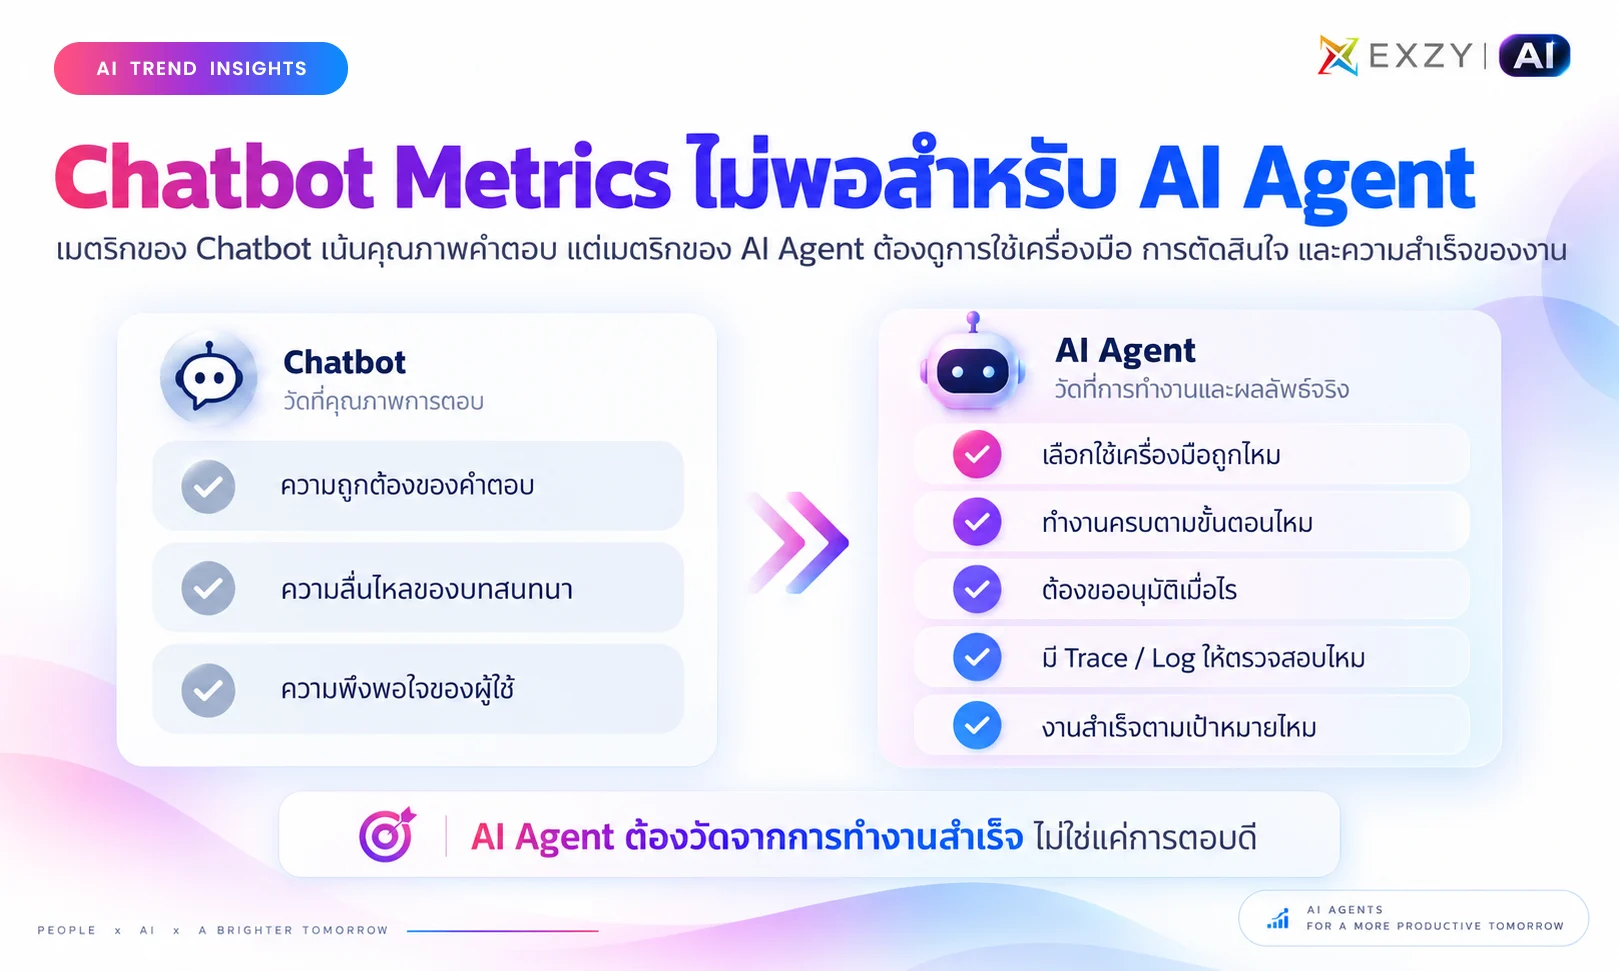
ไม่มี Metric เดียวที่บอกคุณภาพของ Agent ได้ครบ การวัดที่ใช้จริงควรมองทั้ง Outcome, Process และ Operating Cost
1. Task Success / Completion
Task สำเร็จตาม Success Criteria หรือไม่ และ Environment State หลังจบงานถูกต้องหรือไม่
2. Correctness & Constraint Compliance
ผลลัพธ์ถูกต้องและไม่ละเมิด Policy, Permission, Business Rule หรือข้อจำกัดของ Task หรือไม่
3. Tool & Workflow Reliability
Agent เลือก Tool ถูกหรือไม่ ส่ง Parameter ถูกไหม จัดการ Error/Retry อย่างไร และมี Action ซ้ำหรือข้าม Step หรือไม่
4. Human Correction
คนต้องแก้อะไรหลัง Agent ทำงาน? Correction Rate และขนาดของการแก้เป็นสัญญาณสำคัญ เพราะงานที่ “Complete” แต่ต้องให้คนตามแก้มากอาจไม่สร้าง ROI จริง
5. Cost & Latency per Successful Task
Cost ต่อ Call อาจดูต่ำ แต่ Agent หนึ่ง Task มีหลาย Step สิ่งที่ควรวัดจึงเป็น Cost และ Latency ต่อ Task ที่สำเร็จ ไม่ใช่ต่อ Request เดี่ยว
6. Safety / High-impact Failure
ต้องแยก Failure ที่ผลกระทบต่ำออกจาก Unsafe Action เช่น ส่งข้อมูลผิดคน เปลี่ยนสิทธิ์ผิด Account หรือทำ External Action โดยไม่มี Approval
Eval ต้องจำลอง Environment ไม่ใช่แค่ส่ง Prompt
Anthropic อธิบาย Agent Eval ว่าต้องมี Task, Trial, Grader, Transcript, Outcome และ Evaluation Harness ที่สามารถให้ Tool และ Environment แก่ Agent แล้วตรวจ State สุดท้ายได้
ประเด็นนี้สำคัญเพราะ Agent Performance ไม่ได้ขึ้นกับ Model อย่างเดียว แต่ขึ้นกับ Harness, Tool Description, Permission, Context และ State ของระบบด้วย การทดสอบ Model โดยตัดสิ่งเหล่านี้ออกอาจให้คะแนนที่ดูดีแต่ไม่สะท้อน Production
สำหรับ Workflow ที่มีความแปรปรวน ควรรันหลาย Trial ต่อ Task ไม่ใช่ทดลองครั้งเดียว เพราะ Agent อาจเลือกเส้นทางต่างกันในแต่ละครั้ง และ Grader ต้องยอมรับวิธีแก้ที่แตกต่างกันได้ตราบใดที่ Outcome ถูกต้องและไม่ละเมิด Constraint
อย่าปล่อยให้ Eval กลายเป็น Benchmark ที่สวยแต่ไม่ช่วยธุรกิจ
Eval ที่ดีต้องสะท้อน Failure Mode ของ Product จริง ไม่ใช่สร้างโจทย์ง่ายเพื่อให้ Pass Rate สูงขึ้น
สิ่งที่ควรตรวจเป็นระยะ ได้แก่
- Task ยังเป็นตัวแทนงานของผู้ใช้จริงหรือไม่
- Success Criteria ชัดพอหรือไม่
- Grader ลงโทษ Solution ที่ถูกต้องเพียงเพราะเดินคนละเส้นทางหรือไม่
- มี Edge Case และ Negative Case หรือไม่
- Eval เริ่ม Saturate จนแยกความสามารถของ Version ใหม่ไม่ได้หรือไม่
- Failure ใหม่จาก Production ถูกนำกลับเข้าชุด Regression Test หรือยัง
Anthropic แนะนำให้ทีมอ่าน Transcript และ Grade จริงอย่างสม่ำเสมอ เพราะตัว Eval เองก็ผิดได้ เช่น Grader อาจปฏิเสธวิธีแก้ที่ถูกหรือ Harness อาจจำกัด Agent มากเกินไป
Exzy Perspective: เริ่มออกแบบ Eval ตั้งแต่ตอนนิยาม Workflow
สำหรับ Exzy AI เรามองว่า Agent Evaluation ไม่ควรเป็น Step ท้ายหลังสร้างระบบเสร็จ แต่ควรถูกออกแบบตั้งแต่ตอนกำหนด Business Outcome
ก่อนสร้าง Agent ให้ตอบได้ว่า
- Task เริ่มต้นจาก State ไหน?
- Success State คืออะไร?
- Action ไหนห้ามเกิด?
- ขั้นตอนไหนต้อง Human Approval?
- Tool ไหนอนุญาตให้ใช้?
- ความผิดพลาดแบบไหนยอมรับได้?
- Cost และเวลาต่อ Task เท่าไรจึงคุ้ม?
เมื่อ Success Criteria ชัด ทีม Product, Engineering และ Business จะคุยเรื่อง “Agent ดีขึ้นหรือไม่” ด้วยภาษาเดียวกัน และสามารถตัดสินใจเรื่อง Model Upgrade หรือ Autonomy จาก Evidence แทนความรู้สึก
สิ่งที่องค์กรควรทำต่อ
- เลือก Workflow จริง 20–50 Cases รวมทั้งเคสปกติและเคสที่มีโอกาสผิดพลาด
- กำหนดผลลัพธ์ที่ “ควรได้” และ “ห้ามเกิด” ของแต่ละ Task
- กำหนดวิธีตรวจผล เช่น Rule, System Check หรือ Human/AI Review
- บันทึกสิ่งที่ AI ทำ ตั้งแต่ Tool Calls จนถึง Final Outcome
- วัด Success Rate, การแก้ไข, Cost, Latency และ Failure สำคัญ
- นำ Failure ที่พบจริงมาเพิ่มเป็น Test Case
- ทดสอบ Model, Prompt หรือ Tool เวอร์ชันใหม่ก่อน Release ทุกครั้ง
- กำหนดผู้รับผิดชอบและอัปเดต Test Suite เมื่อ Workflow เปลี่ยน
มีโปรเจกต์หรือโจทย์ธุรกิจที่อยากนำ AI มาใช้?
หากองค์กรของคุณกำลังมองหาวิธีนำ AI มาใช้กับงานจริง แต่ยังไม่แน่ใจว่าควรเริ่มจากจุดไหน หรือ Use Case แบบใดจะเหมาะกับธุรกิจมากที่สุด สามารถพูดคุยกับทีมผู้เชี่ยวชาญของ EXZY AI ได้
เราช่วยตั้งแต่วิเคราะห์โจทย์และ Workflow ที่มีอยู่ มองหาโอกาสที่ AI สามารถเข้ามาช่วยลดขั้นตอน เพิ่ม Productivity หรือยกระดับกระบวนการทำงาน ไปจนถึงออกแบบแนวทางและพัฒนา AI Solution ที่เหมาะกับบริบท ข้อมูล ระบบ และข้อจำกัดของแต่ละองค์กร
พูดคุยกับทีม EXZY AI ได้ที่
Facebook: Exzy AI
โทร. 095-919-1963
FAQs
AI Agent Evaluation คืออะไร?
AI Agent Evaluation คือการทดสอบว่า Agent สามารถทำ Task ให้สำเร็จภายใต้ Environment, Tools และ Constraints ที่ใกล้เคียงการใช้งานจริงหรือไม่ โดยวัดทั้ง Outcome และ Process ไม่ใช่ดูเฉพาะข้อความคำตอบสุดท้าย
ทำไม Answer Quality อย่างเดียวไม่พอสำหรับ AI Agent?
เพราะ Agent สามารถตอบข้อความได้ถูกแต่ทำ Action ผิดหรือไม่สำเร็จ เช่น อัปเดต Record ผิด ส่ง Tool Parameter ผิด หรือไม่ได้เปลี่ยน State ในระบบตามที่ Task ต้องการ จึงต้องตรวจ Outcome จริงด้วย
Metric หลักของ Agent ควรมีอะไรบ้าง?
อย่างน้อยควรมี Task Success/Completion, Correctness, Constraint Compliance, Tool Reliability, Human Correction, Cost, Latency และ High-impact Failure โดยเลือกน้ำหนักตามความเสี่ยงของ Workflow
ควรสร้าง Eval เมื่อไร?
ควรเริ่มตั้งแต่กำหนด Product Requirement เพราะการเขียน Eval บังคับให้ทีมระบุ Success Criteria และ Edge Case ให้ชัด จากนั้นใช้เป็น Regression Suite ตลอด Lifecycle ของ Agent