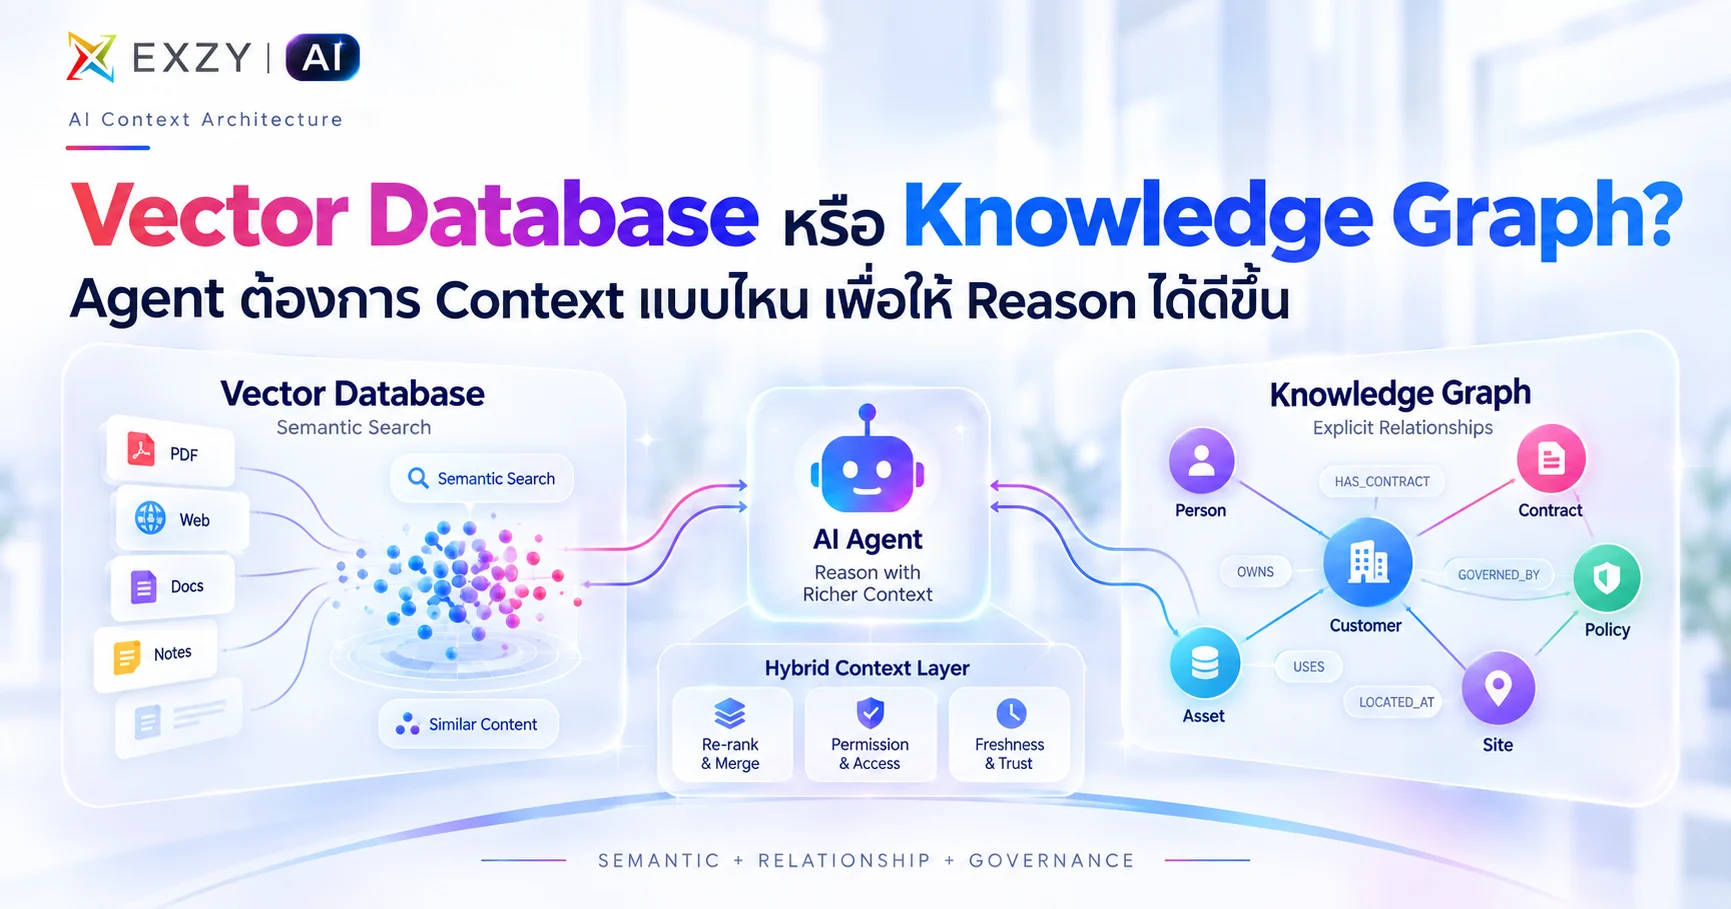
AI Agent ที่ตอบได้ดี ไม่ได้ขึ้นอยู่แค่โมเดลที่ฉลาด แต่ขึ้นอยู่กับ Context ที่ระบบส่งให้ด้วย การเลือกใช้ Vector Database หรือ Knowledge Graph จึงไม่ใช่แค่เรื่อง Architecture เพราะแต่ละแบบช่วยให้ Agent “เข้าใจข้อมูล” คนละมิติ และอาจส่งผลโดยตรงต่อคุณภาพการ Reason และการตัดสินใจ
EXZY AI ชวนคุณมาทำความรู้จักความแตกต่างระหว่าง Vector Database และ Knowledge Graph พร้อมสำรวจว่า Enterprise AI Agent ต้องการ Context แบบไหน และเมื่อไรที่ Hybrid Context อาจเป็นคำตอบที่เหมาะกว่า
Table of Contents
ToggleVector Database กับ Knowledge Graph ไม่ได้เป็นคู่แข่งกันเสมอไป
เมื่อองค์กรสร้าง AI Agent คำถามที่มักเกิดขึ้นคือ “ควรเก็บความรู้ไว้ใน Vector Database หรือ Knowledge Graph?” แต่ในระบบจริง คำถามนี้อาจตั้งต้นผิด เพราะสองเทคโนโลยีถูกออกแบบมาเพื่อแก้คนละปัญหา
Vector Search เก่งการหาเนื้อหาที่ “มีความหมายใกล้เคียง” แม้ผู้ใช้จะใช้คำไม่ตรงกับเอกสาร ขณะที่ Knowledge Graph เก่งการเก็บความสัมพันธ์ที่ชัดเจนระหว่าง Entity เช่น ลูกค้าคนนี้อยู่บริษัทใด สัญญาฉบับนี้อ้างอิง Policy ไหน หรือ Asset ตัวนี้เชื่อมกับ Site ใด
Agent ที่ต้องตอบคำถามง่ายอาจใช้ Vector Search อย่างเดียวได้ดี แต่ Agent ที่ต้องตัดสินใจใน Workflow จริงมักต้องเข้าใจทั้ง “เนื้อหาเกี่ยวกับอะไร” และ “สิ่งนั้นสัมพันธ์กับอะไร ภายใต้ข้อจำกัดอะไร”
Vector Database เหมาะกับ Context แบบ Semantic
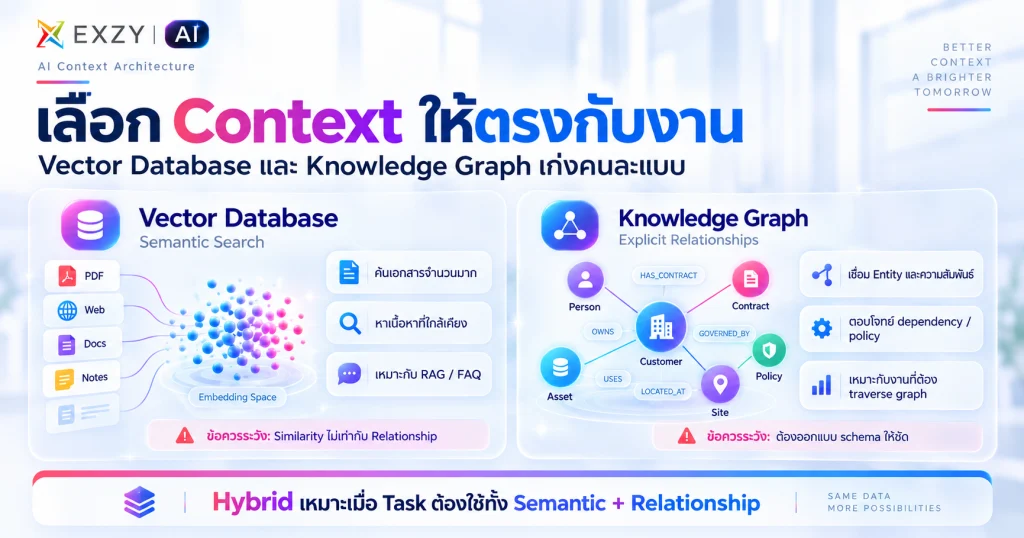
จุดแข็งของ Vector Database คือการเปลี่ยนข้อความ รูปภาพ หรือข้อมูลอื่นให้เป็น Embedding แล้วค้นหาสิ่งที่ใกล้เคียงกันในเชิงความหมาย
ตัวอย่างเช่น พนักงานถามว่า “นโยบายคืนสินค้าแบบเร่งด่วนทำอย่างไร?” ระบบอาจหาเอกสารที่พูดถึง expedited return แม้คำในเอกสารไม่ตรงกับคำถาม
Vector Search จึงเหมาะกับงานอย่าง:
- การค้นเอกสารจำนวนมาก
- FAQ และ Knowledge Assistant
- การหาเนื้อหาที่ใกล้เคียง
- การ Retrieve Context ให้โมเดลก่อนตอบ
- การค้นหาจากภาษาธรรมชาติที่ไม่รู้ Schema ล่วงหน้า
ข้อจำกัดคือ Similarity ไม่ได้เท่ากับ Truth หรือ Relationship เสมอไป เอกสารสองชิ้นอาจมีความหมายใกล้กันแต่ใช้กับคนละ Region คนละ Product Version หรือคนละสิทธิ์
Knowledge Graph เหมาะกับ Context แบบ Relationship
Knowledge Graph เก็บ Entity และความสัมพันธ์ระหว่าง Entity แบบ explicit เช่น
- Customer → owns → Contract = ลูกค้ารายนี้เป็นเจ้าของสัญญานี้
- Contract → governed by → Policy = สัญญานี้อยู่ภายใต้นโยบายนี้
- Policy → valid in → Thailand = นโยบายนี้มีผลใช้ในประเทศไทย
- Asset → located at → Building A = สินทรัพย์นี้อยู่ที่อาคาร A
- Employee → has role → Finance Approver = พนักงานคนนี้มีสิทธิ์อนุมัติด้านการเงิน
โครงสร้างแบบนี้ทำให้ Agent สามารถ traverse ความสัมพันธ์และตอบคำถามเชิง dependency ได้ดีขึ้น เช่น “Policy ไหนใช้กับสัญญาของลูกค้ารายนี้?” หรือ “ห้องนี้มี Sensor ตัวใด และ Sensor ตัวไหนอยู่ใน maintenance window?”
Siemens อธิบายบทบาทของ Graph/Context Layer ในระบบ Agentic AI ว่าเป็นชั้นที่ช่วยให้โมเดลเชื่อมความรู้กับความสัมพันธ์ของข้อมูลแทนการมองเอกสารเป็นก้อนแยกกัน
Agent ในองค์กรต้องการ Context มากกว่าการค้นหา
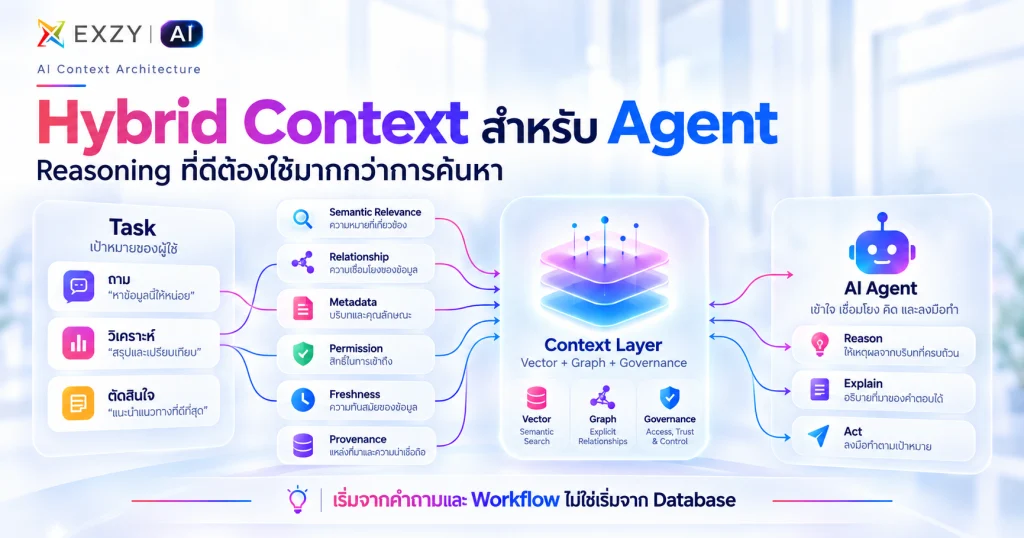
ปัญหาของ Enterprise Agent ไม่ใช่แค่ “หาเอกสารที่เกี่ยวข้องให้เจอ” แต่ต้องรู้ด้วยว่าเอกสารไหนใช้ได้จริงในสถานการณ์นี้
Context ที่ Production Agent มักต้องใช้ประกอบกันมีอย่างน้อย:
- Semantic relevance – ข้อมูลอะไรเกี่ยวกับ Task นี้
- Entity relationship – คน ระบบ เอกสาร และ Asset เกี่ยวข้องกันอย่างไร
- Metadata – Region, Version, Owner, Data Class
- Permission – ผู้ใช้หรือ Agent มีสิทธิ์เห็นและทำอะไร
- Temporal state – ข้อมูลใดคือสถานะล่าสุด
- Provenance – ข้อมูลมาจาก Source ใดและตรวจสอบย้อนกลับได้หรือไม่
นี่คือเหตุผลที่การเลือกฐานข้อมูลเพียงชนิดเดียวจากกระแส มักไม่พอสำหรับงานที่ซับซ้อน
Hybrid Context ไม่ได้หมายถึงต้องทำระบบใหญ่ตั้งแต่วันแรก
การใช้ Vector และ Graph ไม่จำเป็นต้องเริ่มจากระบบที่ซับซ้อน ควรเริ่มจากดูว่า AI Agent ต้องค้นหาอะไร เข้าใจความสัมพันธ์แบบไหน และต้องทำงานต่ออย่างไร
- ถ้าต้องค้นเอกสารและสรุปข้อมูล ใช้ Vector Search อาจเพียงพอ
- ถ้าต้องเข้าใจความสัมพันธ์หลายชั้น Graph จะเหมาะกว่า
- ถ้าต้องใช้ทั้งเนื้อหาและความสัมพันธ์ ค่อยใช้ทั้งสองแบบร่วมกัน
- ถ้า AI ต้องลงมือทำงานจริง ต้องเพิ่มเรื่องสิทธิ์ ข้อมูลที่อัปเดต การตรวจสอบย้อนหลัง และการควบคุมโดยคนด้วย
สถาปัตยกรรมควรตาม Workflow ไม่ใช่ตามเทรนด์
ก่อนเลือกว่าจะใช้ Vector Database, Graph Database หรือใช้ทั้งสองแบบร่วมกัน องค์กรควรเริ่มจากความต้องการของ AI Agent ก่อน ไม่ใช่เริ่มจากเทคโนโลยี
คำถามสำคัญที่ควรถาม เช่น
- Agent ต้องตอบคำถามแบบไหน?
- ต้องเข้าใจข้อมูลหรือ Entity อะไรบ้าง?
- ความสัมพันธ์ใดมีผลต่อคำตอบหรือการตัดสินใจ?
- ข้อมูลส่วนไหนเปลี่ยนแปลงบ่อย?
- ใครมีสิทธิ์เข้าถึงข้อมูลอะไร?
- ถ้า Agent ลงมือทำงาน จะตรวจสอบย้อนหลังได้อย่างไรว่าตัดสินใจจากข้อมูลไหน?
คำตอบเหล่านี้จะช่วยบอกได้ชัดกว่าว่า Architecture แบบไหนเหมาะสม แทนที่จะเลือกจากว่าเทคโนโลยีไหนใหม่หรือทันสมัยกว่า
Exzy Perspective: Context Layer ที่ดีทำให้ AI ใช้ข้อมูลถูกที่ ไม่ใช่แค่หาเจอ
สำหรับ Exzy AI เรามองว่าความได้เปรียบของ Enterprise AI ไม่ได้เกิดจากการเชื่อมข้อมูลให้ได้มากที่สุด แต่เกิดจากการส่ง Context ที่ “เกี่ยวข้อง ถูกสิทธิ์ สดพอ และตรวจสอบได้” ให้ AI ในแต่ละ Task
Vector Search ช่วยเรื่องความใกล้เคียง Knowledge Graph ช่วยเรื่องความสัมพันธ์ แต่ Intelligence จริงเกิดจาก System Design ที่รู้ว่าจะใช้ข้อมูลแบบไหนเมื่อไร
ถ้า Agent ต้องตัดสินใจหรือ Action ต่อ ระบบควรเชื่อม Context Layer เข้ากับ Tool Access, Permission, Evaluation และ Human Handoff ตั้งแต่ต้น
สิ่งที่องค์กรควรทำต่อ
- เริ่มจากงานและคำถามที่ AI ต้องตอบ ไม่ใช่เริ่มจากเลือก Database
- ระบุข้อมูลสำคัญและความสัมพันธ์ที่ AI ต้องเข้าใจ
- กำหนดให้ชัดว่าข้อมูลไหนเป็นแหล่งข้อมูลหลัก และต้องมีรายละเอียดประกอบอะไรบ้าง
- เริ่มจากการค้นหาข้อมูลตามความหมายก่อน แล้วค่อยเพิ่ม Graph เมื่อต้องเชื่อมโยงความสัมพันธ์หลายชั้นจริง ๆ
- กำหนดสิทธิ์การเข้าถึง และตรวจว่าข้อมูลยังเป็นปัจจุบันตั้งแต่ขั้นตอนการค้นหา
- ทดสอบว่า AI ค้นข้อมูลได้ถูกต้อง และนำข้อมูลนั้นไปทำงานต่อได้สำเร็จหรือไม่
- วัดต้นทุนและความเร็วก่อนเพิ่มความซับซ้อนให้ระบบ
มีโปรเจกต์หรือโจทย์ธุรกิจที่อยากนำ AI มาใช้?
หากองค์กรของคุณกำลังมองหาวิธีนำ AI มาใช้กับงานจริง แต่ยังไม่แน่ใจว่าควรเริ่มจากจุดไหน หรือ Use Case แบบใดจะเหมาะกับธุรกิจมากที่สุด สามารถพูดคุยกับทีมผู้เชี่ยวชาญของ EXZY AI ได้
เราช่วยตั้งแต่วิเคราะห์โจทย์และ Workflow ที่มีอยู่ มองหาโอกาสที่ AI สามารถเข้ามาช่วยลดขั้นตอน เพิ่ม Productivity หรือยกระดับกระบวนการทำงาน ไปจนถึงออกแบบแนวทางและพัฒนา AI Solution ที่เหมาะกับบริบท ข้อมูล ระบบ และข้อจำกัดของแต่ละองค์กร
พูดคุยกับทีม EXZY AI ได้ที่
Facebook: Exzy AI
โทร. 095-919-1963
FAQs
Vector Database ต่างจาก Knowledge Graph อย่างไร?
Vector Database เหมาะกับการค้นหาข้อมูลที่มีความหมายใกล้เคียงกัน เช่น หาเอกสารที่เกี่ยวข้อง ส่วน Knowledge Graph เหมาะกับการเชื่อมโยงว่าใคร อะไร และข้อมูลไหนเกี่ยวข้องกันอย่างไร